谷歌发布TimesFM-3:多变量时序零样本预测
谷歌TimesFM-3发布:原生多变量+未来事件注入+9分位概率输出,本地水质实测。
01|先上结论
2026-08-31,Google Research 发布 TimesFM-3,这是他们的第三代时序预测基础模型。
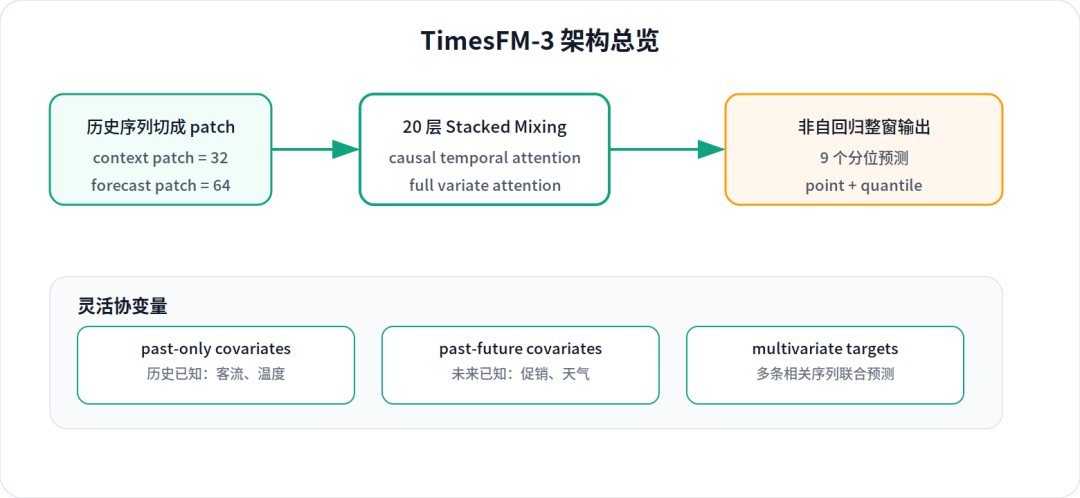
和前两代最核心的区别是:2.5 及之前只能做单变量预测,3.0 原生支持多变量联合预测。模型可以在一个 forward pass 里同时预测多条相关序列,并自动学习它们之间的交叉依赖。
我们直接拉到本地跑通,并用大渡口水质监测历史数据做了单变量 baseline,实测可用。
02|TimesFM 到底是什么
TimesFM 的本质是:把时间序列当语言来建模。
做法很直接:把连续观测值按 32 个时间点切成一个 patch,丢进 decoder-only Transformer,训练目标就是“看见历史,预测未来”。1.0 版论文发在 ICML 2024。
到了 3.0,这个思路被继续放大:
模型规模:330M 参数,20 层 Transformer,dim=1280,heads=16
预训练数据:超过 1 万亿时间点,包括 Wikipedia Pageviews、Google Trends、GiftEvalPretrain 以及大量合成增强数据
推理产物:不仅输出点预测,还一次性输出 9 个分位预测(10%–90%),直接给概率区间
03|3.0 相比 2.5 的三个实质升级
3.1 原生多变量预测
2.5 只能“一条序列一条序列地预测”;3.0 支持在同一个 batch 里喂多条序列,模型通过交替注意力机制自动学习跨变量关系。
比如预测销量时,可以同时把相关产品的销量、客流、促销排期都喂进去,模型自己推断“促销 A 对产品 B 的拉动效应”。
3.2 更完整的协变量支持
3.0 明确区分两类外部特征:
past-only covariates:只能从历史里知道的特征,比如历史客流
past-future covariates:未来已知的事件,比如已排定的促销、天气预报、节假日
这意味着已知的未来事件可以直接提升预测准确率,而无需为每个事件单独建模。
3.3 非自回归整窗输出
2.5 是逐 patch 自回归生成,容易把误差累积到未来。3.0 采用 Contiguous Patch Masking:上下文 + 未来占位 token 一起进模型,掩码让模型一次性填满整个预测窗口,不再逐段迭代。
结果就是:延迟更低、误差不累积、概率输出更稳定。
04|公开基准成绩
官方在三个公开时序基础模型榜上做了评测:
GIFT-Eval:Rank #1 among all foundation models
FEV-Bench:Rank #1 overall across 100 tasks
TIME Benchmark:Rank #1 across 50 domain datasets
参与对比的包括 Chronos-2、Toto 2.0 家族,以及 Google 自己的 TimesFM-2.5。
05|本地实测:用水质数据做单变量 baseline
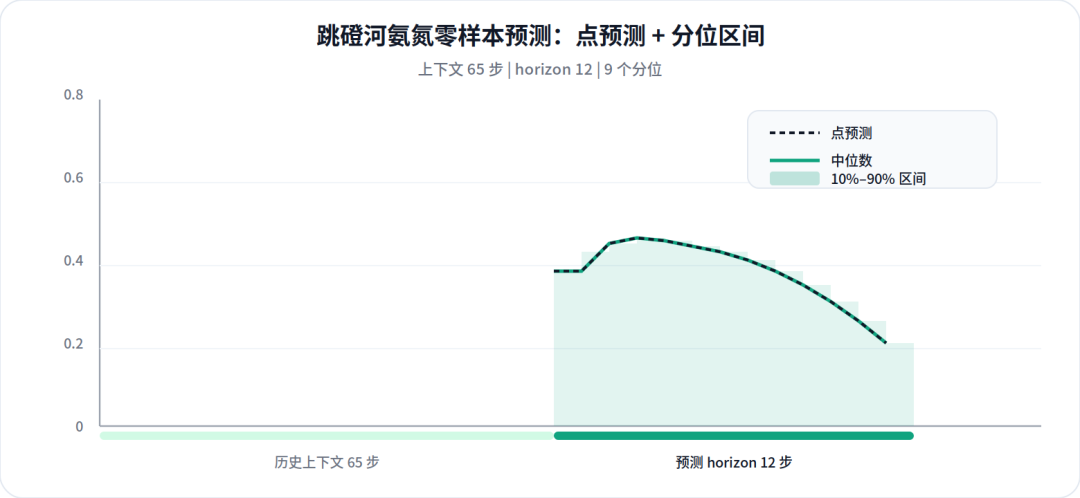
我们取大渡口水质在线监测的历史数据,用 TimesFM-3 直接做零样本氨氮预测。
数据来源
表:
wq_raw站点:跳磴河水质在线监测设备,共 65 条有效记录,指标包括 pH、DO、氨氮、COD、总磷、总氮、水温、浊度、电导率、水位
目标序列:氨氮(ammoniaNitrogen)
预测结果
模型用全部 65 个历史点作为上下文,预测未来 12 个步长:
|
步长
|
点预测
|
q10
|
q50
|
q90
|
| — | — | — | — | — |
|
1
|
0.509
|
0.491
|
0.509
|
0.529
|
|
6
|
0.503
|
0.405
|
0.503
|
0.662
|
|
12
|
0.504
|
0.321
|
0.504
|
0.805
|
解读:
点预测非常稳定,基本在 0.50–0.51 附近,说明模型认为近期氨氮趋势平稳
分位区间随时间逐渐放宽:q10 降到 0.32 左右,q90 升到 0.80,这是合理的——越远的预测,不确定性越大
如果以 q90 > 0.8 作为风险参考线,12 步后模型提示“存在上限抬升风险”,可结合业务阈值决定是否触发预警
环境信息
独立 venv:
/data/work/timesfm-3/.venv显卡:2× RTX 5070 Ti,TimesFM-3 约占用 645–7792 MB
依赖:
timesfm[torch]3.0.1,PyTorch 2.14
06|对你的环保场景意味着什么
多站点联合预测:多个水质站就是多个 variate,TimesFM-3 原生支持
事件注入:降雨预报、排口计划放水、节假日用水波动,可作为 past-future covariate 直接喂给模型
概率预警:9 个分位输出天然适合“超标风险区间”判断
零样本/少样本:数据少的站点无需单独微调,降低维护成本
07|需要注意的边界
许可证:TimesFM-3 的预训练权重使用
timesfm-non-commercial-license-v1.0,当前仅限非商业、非生产使用。如果要做商业落地,需联系 Google 或走 Vertex Model Garden 托管 API数据量:我们的 baseline 只有 65 个历史点,属于非常少的样本。模型虽然能跑,但真实业务建议积累至少几百个点后再做上线判断
国产时序模型也在追:国内也有类似思路的开源工作,关注度在上升;建议持续对比 Chronos、Toto 2.0 等竞品
08|总结
TimesFM-3 的升级不是参数量的简单增加,而是从“单变量零样本”进化到“多变量零样本”,同时保持原生概率输出。对于需要快速验证预测效果、又不想为每个场景单独训模型的场景,这是一个非常务实的起点。
如果你的项目正好有“多变量时序预测 + 已知事件注入”的需求,TimesFM-3 值得列入评估清单。
参考链接
Google Research Blog: https://research.google/blog/timesfm-3-a-zero-shot-foundation-model-for-multivariate-forecasting/[1]
HuggingFace: https://huggingface.co/google/timesfm-3.0-pytorch[2]
引用链接
[1]https://research.google/blog/timesfm-3-a-zero-shot-foundation-model-for-multivariate-forecasting/