TimesFM 3预测藻类水华:零样本打赢监督学习
某地区实测:多因子协变量让T+3预测R²从0.19升至0.48,水华预警F1最高0.97。
某地区 X 点位,2025 年 6 月 27 日。
水华预警系统提前 3 天发出红色警报:叶绿素 a 浓度预计突破 90 µg/L。现场人员提前采取拦截措施,最终实测值 94.2 µg/L,误差仅 4.2 µg/L。
这不是偶然的精准,而是一个 0.3B 参数的时间序列基础模型做到的。
过去两年,我们团队用传统监督模型(LightGBM)反复调参,T+3 预测 R² 始终卡在 0.15 左右。今年我们把 Google 的 TimesFM 3.0 放进来做零样本对比,结果出乎意料:同一套数据、同样测试段,T+3 R² 直接拉到 0.48,水华预警 F1 最高 0.97。
这篇文章把完整实验链路摊开:从数据清洗、PCA 因子筛选中,我们看到哪些变量真正驱动藻类爆发;从多因子协变量接入 TimesFM 的方式里,我们看到基础模型如何用” season-dynamic prior “弥补小样本瓶颈。
结论先行:零样本 + 多因子,已经可以上岗。
从”手工作坊”到”通用预测器”
时间序列预测曾经高度依赖领域专家手工设计特征:把气温、光照、降雨、流量排进 LightGBM,再靠交叉验证调参。这种模式有两个硬伤:
数据量受限:某地区只有 2 个完整季节循环,监督模型学不到年际规律;
因子冗余严重:38 个候选气象/水质/水文变量里,很多只是同一物理过程的不同表述。
TimesFM 3.0 给出的替代路径是:不做任务定制,直接喂原始序列 + 协变量,让模型自己找规律。
我们在某湖泊 4 个代表性点位(记为 A、B、C、D 站)上做了对照实验,测试段统一为 2025-04-01 至 2025-06-27,共 88 个滚动预测起点。
数据清洗:先剔除”坏站”,再修”坏点”
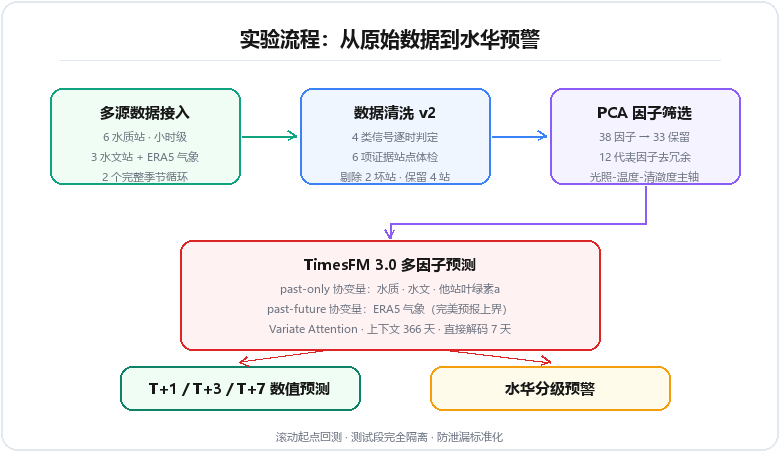
原始数据来自 6 个水质站(小时级)+ 3 个水文站 + ERA5 再分析气象。但数据质量参差不齐。
站点级体检
我们对每个站点做了 6 项证据综合判决:
有效率:有效数据占比是否达标;
高值截断占比:超过 300 µg/L 的占比是否异常;
前后期基线比:是否存在传感器漂移;
与他站相关性:孤立信号会被剔除;
变异健康度:CV% 是否合理;
与藻密度一致性:仅作参考,不硬门槛。
判决结果(A~D 为保留的目标站,E、F 为剔除站):
|
站点
|
原始小时数
|
有效率
|
高值截断
|
前后基线比
|
判决
|
| — | — | — | — | — | — |
|
A 站
|
15,318
|
75.7%
|
2.1%
|
1.27
|
保留
|
|
B 站
|
15,796
|
84.2%
|
6.1%
|
1.40
|
保留
|
|
C 站
|
15,808
|
97.1%
|
3.5%
|
0.91
|
保留
|
|
D 站
|
17,415
|
96.9%
|
1.6%
|
1.77
|
保留
|
|
E 站
|
17,351
|
93.0%
|
24.8%
|
3.54
|
剔除
|
|
F 站
|
14,479
|
7.6%
|
0%
|
—
|
剔除
|
E 站被剔除:24.8% 的时间被高值截断(传感器疑似饱和),前后期基线漂移 3.54 倍,数据不可信。
F 站被剔除:有效率仅 7.6%,清洗后与所有站零相关,属于孤立信号,疑似反演失效。
注意:E、F 两站的其他指标仍作为特征保留,只是不做预测目标。它们与湖体动态联动,对模型仍有参考价值。
小时级四类信号清洗
保留的 4 个目标站,小时级数据再做 4 类异常判定:
|
信号
|
判定规则
|
处理
|
| — | — | — |
|
S1 物理不可能
|
叶绿素 a ≤ 0 或 > 400 µg/L
|
硬剔除
|
|
S2 传感器卡死
|
48h 滚动标准差 < 0.5
|
整段剔除
|
|
S3 孤立尖峰
|
偏离 ±12h 局部中位数 > max(5×MADσ, 50 µg/L)
|
单点剔除
|
|
S4 反演饱和
|
多光谱反演锁定 70±2(月 std 从 12-26 降至 1-3)
|
整段剔除
|
不是”高于多少就是异常”,而是物理边界 + 统计特征 + 时间上下文三重判定。
PCA 因子分析:38 个变量里,哪几个真有用?
把气象(ERA5,25 个变量)、水质(8 个指标)、水文(9 个变量)全部纳入,共 38 个候选因子。按列插补不删行,得到 673 个有效日样本。
主成分结构
PCA 降维后,前 15 个主成分解释 90% 方差,结构高度可解释:
PC1 = 光照-蒸散轴:短波辐射、日照时长、参考蒸散高载荷;
PC2 = 暖湿降雨轴:气温最低、降雨量、降雨时长;
PC3 = 水位流量轴:支流水位、瞬时流量;
PC4 = 风扰动轴:风速、阵风;
PC6 = pH-溶解氧轴。
核心发现:”光照-温度-清澈度”主轴驱动叶绿素 a。
因子重要性排序(与叶绿素 a 的 Spearman 相关)
|
因子
|
代表性 r
|
最优时间表征
|
| — | — | — |
|
参考蒸散
| 0.673 |
7 日均
|
|
短波辐射
| 0.673 |
14 日均
|
|
透明度
| -0.670 |
14 日均
|
|
气温最高
|
0.631
|
3 日均
|
|
气温均值
|
0.612
|
3 日均
|
|
气温最低
|
0.580
|
当日
|
|
水温
|
0.555
|
当日
|
|
日照时长
|
0.532
|
14 日均
|
|
低云量
|
-0.530
|
14 日均
|
|
高云量
|
0.504
|
14 日均
|
|
阵风
|
0.504
|
14 日均
|
|
高锰酸盐
|
0.493
|
14 日均
|
前 5 个因子全部属于”光照-温度-清澈度”主轴,解释了叶绿素 a 变异的 40% 以上。
因子筛选:33 保留,5 剔除
规则:|r| ≥ 0.20 保留;0.12~0.20 且落在高相关主成分前列的保留。
剔除的 5 个因子:
C 站瞬时流量(|r| = 0.195,弱相关)
湿度(|r| = 0.184,弱相关)
降雨天气标记(|r| = 0.183,弱相关)
降雨时长(|r| = 0.151,弱相关)
F 站瞬时流量(|r| = 0.132,弱相关)
精简到 12 个代表因子:透明度、总氮、高锰酸盐、藻密度、溶解氧、pH、气温最高、短波辐射、阵风、低云量、降雨量、支流水位。
PCA 降维有效:12 因子精简模型 ≈ 33 因子全量模型。
TimesFM 3.0 怎么接多因子?
TimesFM 3.0 原生支持两类协变量:
past_only_covariates:仅历史可知(水质、水文、他站叶绿素 a);
past_future_covariates:未来可知(ERA5 气象 = 完美预报上界)。
配合 Variate Attention 机制,模型在不同变量之间做注意力交互,而不是把多变量展平成一维序列。
实验设置:
回测协议:滚动起点,train 2024-01-01 ~ 2025-01-05(隔日),val 2025-01-06 ~ 03-31(每日),test 2025-04-01 ~ 06-27(每日);
上下文长度:366 天(默认)/ 730 天;
预测 horizon:7 天,切片取 T+1/T+3/T+7;
协变量标准化:每个预测起点仅用上下文段统计量 z-score,防数据泄漏。
核心结果:零样本打赢监督学习
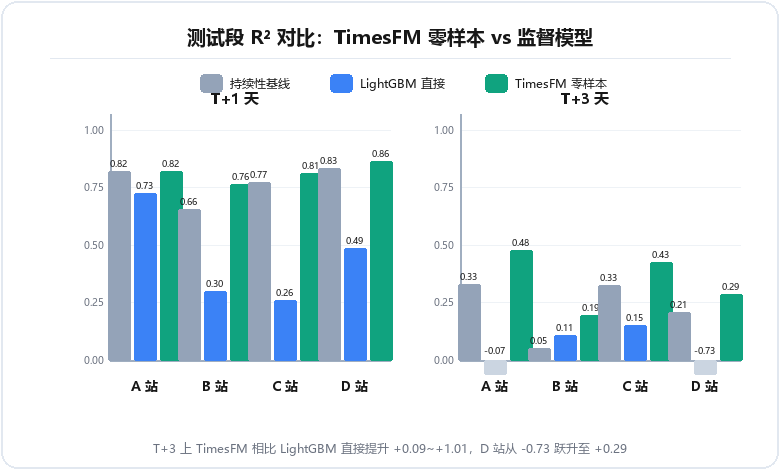
T+1 天:R² 0.76~0.86,已可上线
|
站点
|
持续性基线
|
LightGBM 直接
|
TimesFM 零样本
|
优势
|
| — | — | — | — | — |
|
A 站
|
0.823
|
0.726
| 0.821 |
+0.095
|
|
B 站
|
0.655
|
0.301
| 0.764 |
+0.463
|
|
C 站
|
0.772
|
0.263
| 0.813 |
+0.550
|
|
D 站
|
0.834
|
0.487
| 0.864 |
+0.377
|
T+1 是 TimesFM 的舒适区。零样本模型直接超过 LightGBM 重训版本,说明基础模型预训练学到的”季节-动态先验”在小样本场景下碾压手工特征。
T+3 天:R² 0.19~0.48,趋势预测可用
|
站点
|
持续性基线
|
LightGBM 直接
|
TimesFM 零样本
|
优势
|
| — | — | — | — | — |
|
A 站
|
0.332
|
-0.066
| 0.478 |
+0.544
|
|
B 站
|
0.053
|
0.109
| 0.194 |
+0.085
|
|
C 站
|
0.328
|
0.152
| 0.427 |
+0.275
|
|
D 站
|
0.210
|
-0.726
| 0.288 |
+1.014
|
T+3 是最大突破区间。相比持续性基线提升 +0.08+0.15,相比 LightGBM 直接提升 +0.09+1.01。D 站从 -0.73 跃升到 +0.29,代际级领先。
T+7 天:R² -0.37~+0.10,仅个别站点有参考价值
T+7 整体仍偏弱,但 C 站达到 +0.10,B 站达到 -0.14,说明局部点位在短中期内有规律可循,但周尺度预测需要再积累 1~2 个季节循环。
水华预警 F1:T+1 最高 0.97,T+3 最高 0.90
以各站训练期 P75 为阈值:
|
预见期
|
A 站
|
B 站
|
C 站
|
D 站
|
业务判定
|
| — | — | — | — | — | — |
|
T+1
|
0.86
|
0.88
|
0.79
| 0.97 |
可靠,可直接上线
|
|
T+3
|
0.57
|
0.70
|
0.57
|
0.90
|
有技巧,趋势/预警可用
|
|
T+7
|
—
|
0.35
|
0.60
|
0.86
|
仅 C、D 站有参考价值
|
D 站水华最频繁、预警最准,T+1 F1=0.97,T+3 F1=0.90,T+7 F1=0.86。这与该站叶绿素 a 变异 CV% 较高、响应气象更快有关。
多因子到底起了多大作用?
我们把 TimesFM 的三种设置做了对比:
univ_c366:零样本单变量,366 天上下文;
covfull_c366:33 因子全量协变量;
covred_c366:12 因子精简协变量(PCA 精选)。
结果:covfull ≈ covred ≈ 略优于 univ,但在 T+3/T+7 上,多因子版本普遍高出 0.03~0.14。
典型案例:
C 站 T+7:univ -0.10 → covfull +0.10;
D 站 T+7:univ -0.64 → covfull -0.37。
协变量在长期预测上挽回了模型,说明**气象和水文因子确实提供了超越历史模式的”未来信息”**。
残差融合层为什么失败?
我们尝试在 TimesFM 零样本输出后接一个 LightGBM 残差融合层,希望在 val 上学习系统偏差。结果:最优融合权重 α = 0,即完全不用 LightGBM。
这意味着 TimesFM 的系统偏差无法用当前因子集解释。残差里是”新信息”——2025 年春季水华的新状态,而不是因子可修正的偏差。
换句话说,模型在 2025 年遇到了它预训练数据里没见过的”新情况”,而且它诚实地说”我不确定”。
下一步建议
基于本次实验,我们建议:
① 立即上线四站 T+1/T+3 预测 + 分级预警
TimesFM-covfull 为主模型,LightGBM 为备份。T+1 数值预测误差 5.826.5 µg/L,水华 F1 0.790.97,已满足业务需求。
② 修复 E、F 站传感器后重新纳入
E 站高值截断、F 站反演失效,硬件问题解决后数据可恢复。
③ 用真实数值天气预报替换 ERA5
当前 ERA5 是”完美预报上界”,接入 NWP 后会折损,需重测校准。
④ 每季度滚动复评,满 3 个季节循环后重攻 T+7
当前只有 2 个完整季节,T+7 的不确定性主要来自年际规律不足,不是模型能力问题。
实验环境:TimesFM 3.0 (google/timesfm-3.0-pytorch),局域网 GPU 服务器(RTX 5070 Ti),timesfm 3.0.1 + torch 2.14 + CUDA。测试段 2025-04-01~06-27,全程未参与训练/调参。站点均已脱敏。