长文本写作引擎:先定大纲,再一章一章写
长稿一次写到底,结构容易漂移。改成大纲先确认、一章一文件,再用 pandoc 出 docx。
让 AI 一口气写三万字,前两章往往让你很满意。
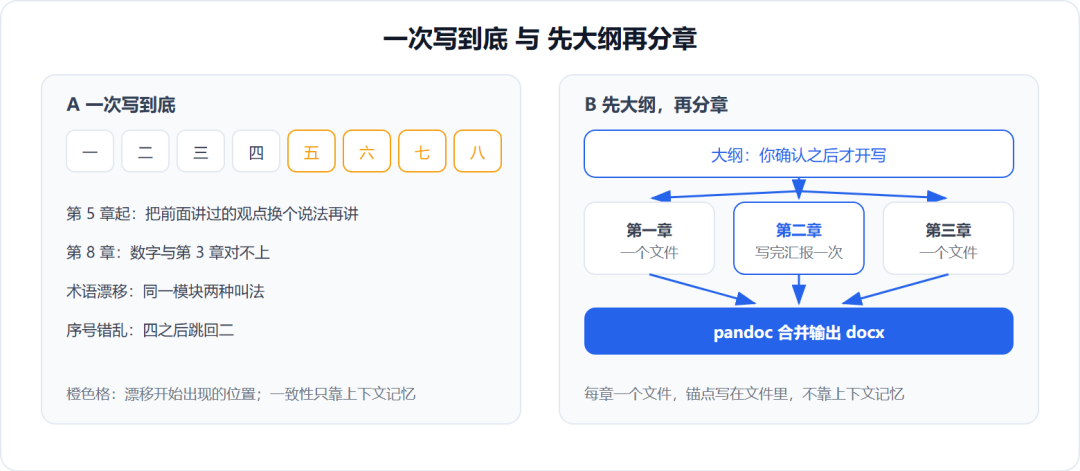
到第五章,它开始把前面讲过的观点换个说法再讲一遍;第八章冒出一个数字,跟第三章对不上;同一个模块,前面叫「调度器」,后面变成「调度中心」;章节序号也可能从「四」跳回「二」。
我试过几轮,每次都发现:真正花时间的不是写,是核对前后有没有打架。后来我换了个笨办法——不追求一次写完,先把大纲定死,再一章一章往下推。
我把这半年攒下来的技能陆续上架到了 WorkBuddy,一共 11 个,这是第 7 篇,讲长文本写作引擎。
一、问题在哪
一次生成的长文,崩的地方通常不是单段质量,而是一致性。
单段写得好不好,取决于模型当下那几百字的状态;一致性却要求它记住几万字之前说过什么。这两件事的难度不在一个量级上。
我遇到过的三种典型失效:
结构漂移。该讲接口设计的章节,写着写着跑去讲部署,因为材料里的知识点本来是网状的,没有锚点就会各自发散。
车轱辘话。每一章开头都重新介绍一遍背景,读起来像十篇短文拼成的合集。
前后矛盾。术语、编号、口径、结论,越往后越容易跟前面冲突,而且很难靠通读一遍全部揪出来。
这三个问题的共同点是:一致性全靠上下文里的记忆撑着,窗口一长,记忆就开始丢。
技能文档里给的解法很朴素:把一致性从记忆里挪到文件里。先产出一份你确认过的大纲,再把章节拆成一个个独立文件,每次只写一章,写完一章汇报一次。每写一章都能回头翻大纲和已完成的部分,锚点在文件里,不会随上下文漂移。
拆开看,它治的是三件不同的事。
大纲治结构漂移。章节边界一旦写进文件,写到一半跑题会被大纲拽回来,因为「这一章该讲什么」是有定论的,不靠临场发挥。
一章一文件治车轱辘话。每章都有明确的开头和结尾,背景介绍只在第一章出现,后面引用前面的结论就行,不会每章重新铺一遍。
写完一章汇报一次治前后矛盾。术语、编号、口径在写新章之前先被摆到台面上,冲突在当章就被发现,不用等全稿写完再回头大海捞针。
二、它能做什么
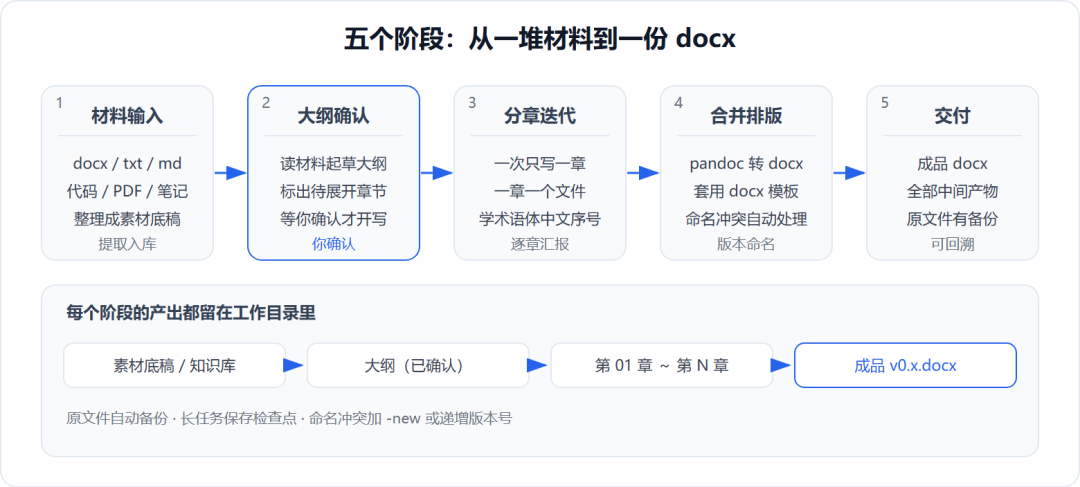
按文档里的定位,它管的是长篇技术文档(教材、研究报告、技术手册)的系统化写作,链路是:材料输入 → 大纲 → 分章迭代 → docx 输出。拆开说是五件事。
多格式材料先入库。docx、txt、md、代码文件、PDF、零散笔记都可以当素材来源,先提取整理成一份工作底稿。这里要提一句:技能描述里把 docx、txt、md、代码、PDF 都写进了输入,而能力清单(v0.1)里明确列出的已支持格式是 .docx、纯文本和 Markdown;扫描版 PDF 和代码解析被放在计划里。
大纲先过你的眼。它读材料、起草大纲、标出哪些章节需要展开,然后停下来等你确认。文档里写得很硬:大纲必须经用户确认后才进入写作。这一步看着多余——真正省时间的恰恰是这一步。
分章迭代写。一次只写一章,一章一个文件。写作风格按学术、专业语体来:用「一、二、三」中文序号,不用项目符号;保持正式的书面语;章节之间要写过渡。写完一章汇报一次。
合并与套模板。全部章节确认后合并,用 pandoc 转成 .docx;可以拿一份现成文档当模板,让字体、标题层级、编号样式跟着模板走。命名冲突也会处理:加 -new 或者递增版本号。
保留全部过程文件。除了最终 docx,素材底稿、大纲、每一章、模板都会留在工作目录里,方便审阅和后续改版。版本号按 v0.x 递增,原文件有自动备份。
文档里还留了一个技术教材的示例,我照着理解了一遍:输入是一份教材草稿、一些代码样例和研究笔记;大纲阶段确认「核心功能模块详解」这一章需要展开;写作阶段六个模块逐章迭代出来;排版阶段直接拿草稿本身当模板,最后输出加了完整编号和格式的新版本。整个过程里,原始草稿没有被覆盖,中间文件也都留着。
三、五步流程
文档把整件事拆成五个阶段:输入处理、大纲开发、分章写作、合并排版、交付。对话里对应几个明确的节点,我按自己的用法排一下。
材料进(init、add-source):给出主题和材料,建立工作目录与知识库,材料一份一份提取录入。
大纲出(outline):自动起草大纲,等你确认。砍章节、调顺序、补要求,都在这一步做。这一步过了,后面的分歧成本才会低。
分章写(develop):按大纲一章一章写,写完一章汇报一次,跑偏了当场就能改。
看进度(status):随时问它写到哪了,它会给出已完成和待写章节的清单。
合并交付(compile):全部确认后用 pandoc 合并输出,同时交出全套过程文件。
我自己的用法是:大纲那一步盯得最紧,分章阶段基本放手。大纲错了,后面几十页都是白写;大纲对了,单章水准差不到哪去。
四、怎么调用
技能市场安装之后,在对话里说人话就能触发。技能文档里写明:它没有独立 CLI,全部通过对话驱动。
可以这么说:
「我要写一份设备运维技术手册,材料在这几个 docx 里,先帮我出大纲」
「按大纲开始写第二章,写完把这一章的要点告诉我」
「现在写到哪了,还差哪几章」
第一句话说清三件事,后面会顺很多:写什么、材料在哪、大概多长。材料给得越具体,大纲越贴合;只说一句「帮我写本书」,出来的大纲只能是大路货。
如果你更习惯手动控制,文档里给了两条命令,可以直接复制。
第一步,用现成文档做模板。样式跟着模板走,比在正文里手动调格式省事得多:
cp original.docx my-template-projectname.docx
第二步,全部章节确认之后,合并转成 docx:
pandoc input.md -o output.docx --reference-doc=my-template.docx
跑完之后,工作目录里留下来的东西大致是这些:
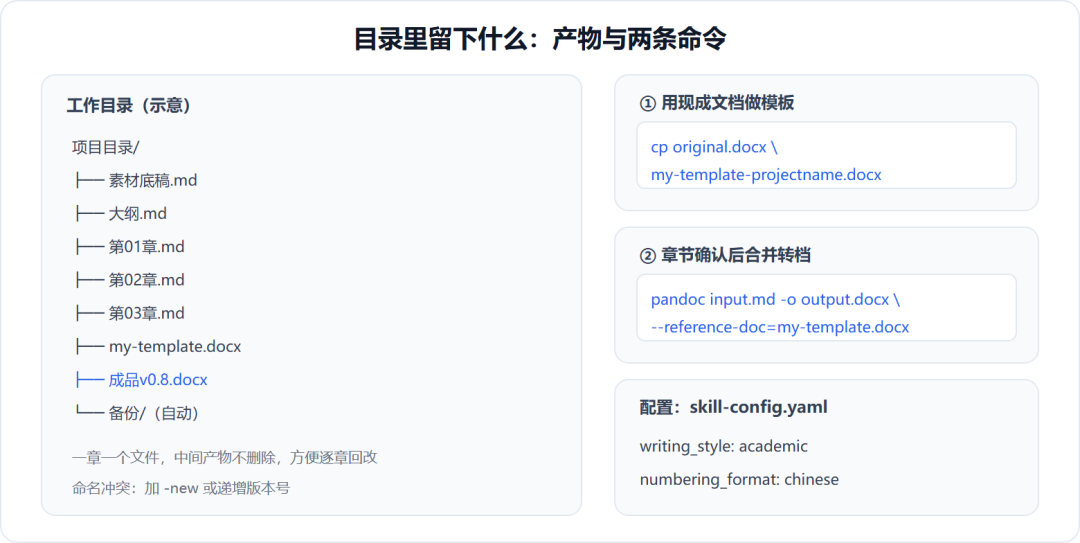
技能还支持一份配置文件,把写作口径固定下来,省得每次重说:
writing_style: academic # academic / technical / business / creative numbering_format: chinese # chinese / arabic / roman template_file: my-template.docx version_prefix: v auto_backup: true preserve_intermediates: true
五、边界与注意
这一节说直白一点。
它不替你提供事实。材料里没有的内容,它写不出来;硬写就是编。所以资料给多厚,章节就有多实。指望它凭一个标题写出一本教材,拿到的多半是漂亮但空洞的段落。
PDF 和代码解析还在路上。技能描述里列了 PDF、代码文件这些输入,但 v0.1 的能力清单写的是 .docx、纯文本、Markdown,路线图里 v0.2 才把 PDF 和代码文件支持列进去。我这次测下来,稳妥的做法是先把材料转成 docx 或 Markdown 再喂给它。
依赖要自己装。pandoc 和 Python 是必须的,Linux、macOS、Windows 都能装,但技能不会替你装。pandoc 不在,最后那步转 docx 就走不通。
它不是「一键长文」按钮。大纲要你确认,章节要你审,要求要在对话里说清楚。它省掉的是组织结构、交叉引用和排版对齐这些机械动作,判断仍然是你的事。
语体可配,但它按长文档设计。配置里的 writing_style 有 academic、technical、business、creative 四档,序号格式有中文、阿拉伯、罗马三种可选。不过它的长处是章节多、篇幅长的结构化文档;营销文案、口播稿这类短平快的东西,用它并不划算,那是另一类工具的活。
它也能接着旧稿往下写。文档里的示例就是从一份已有的教材草稿出发,补写需要展开的模块,最后输出一个新的版本号。也就是说,改版、续写、补章这些场景它同样能接,而且原始文件不会被覆盖。
图表、目录、引用还没做。mermaid 流程图、封面页、自动目录、交叉引用链接、BibTeX 引用管理、术语索引、多语言、批注审阅这些,文档里列在计划增强和路线图里,属于计划,不是现在就能用的功能。
版本管理只管命名。冲突时加 -new 或递增版本号,它是文件级的管理,不做内容 diff,也不会生成修订记录。
另外,技能里确实写了防跑飞的安全措施:文件格式校验、模板兼容性检查、内容长度校验、磁盘空间监控,以及自动备份、长任务检查点保存、出问题回滚。但这些是文件层面的兜底,三万字级别的稿子,人工审阅的时间该留还是得留。
我现在的判断很简单:长文的瓶颈从来不是生成速度,而是前后一致。先定大纲、再分章写,就是把这件事从运气变成流程。
我是文茂,热衷于分享 AI 工具与开发者生态观察。觉得有用欢迎点赞、在看、转发三连。