DEM 水文分析:跑完不知道对不对,才是真麻烦
填洼、D8 流向、汇流累积到子流域划分一次跑完,还留一份可逐项核对的质检报告。
做流域分析的人大概都经历过这个场面:脚本跑完了,目录里躺着一堆 flow_accumulation.tif 和 streams.shp,图也画出来了,可盯着那张河网,心里没底——密度是不是太高了?阈值凭什么是这个数?上游是不是被 DEM 边界切掉了一截?
比「跑不完」更麻烦的,是「跑完了不知道对不对」。我把这半年攒下来的技能陆续上架到了 WorkBuddy,一共 11 个,这是第 2 篇。今天讲的 DEM 水文分析,就是冲着这个问题写的:它不只把流程跑完,还会留下一份可以逐项核对的质检报告。
一、为什么要做
水文分析的步骤教科书上都有:填洼、D8 流向、汇流累积、河网提取、子流域划分。真上手才发现,麻烦不在算法,而在三件事。
一是中间步骤像黑箱。以前我用零散脚本串流程,换个 DEM、换台机器,参数就飘了;出了问题只能一层层翻中间文件,很难分清是数据问题还是参数问题。
二是阈值容易拍脑袋。河网密不密,全看汇水面积阈值。小一点,河网像毛细血管;大一点,只剩几条主干。很多人(包括我)习惯性填个数就跑,跑完也解释不清为什么是它。
三是没人替你写检查清单。文件生成不等于结果可用。出口点有没有落在边界上?流域是不是被裁掉一半?跟参考河网差多少?这些问题以前都靠人盯着图猜。
所以这个技能的目标很直接:把每一步都变成有记录、可核对的一步。我踩过的坑,反过来就成了它的默认行为。
二、八步流水线
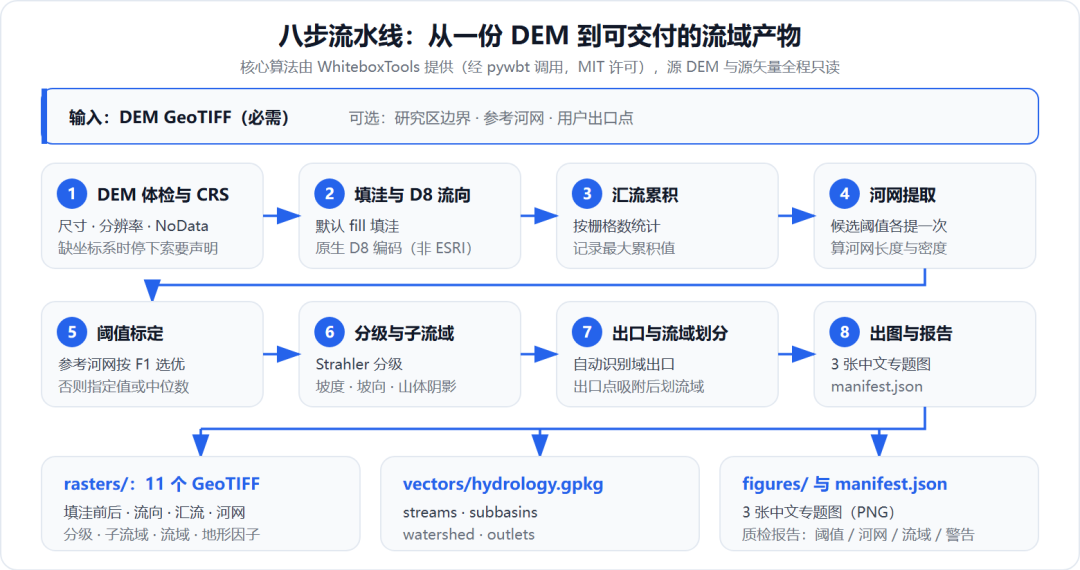
整条链路被固定成八个阶段,全部由 scripts/hydrology.py 调用 WhiteboxTools 完成,源 DEM 全程只读。
DEM 体检与坐标系处理:读取尺寸、分辨率、波段、NoData、坐标系,并做诊断——像元是否正方形、有效栅格占比是否过低;坐标系缺失时直接停下要人声明,绝不按坐标数值猜。
填洼、D8 流向、汇流累积:技能文档写明默认策略是 fill 填洼,汇流累积按栅格数统计。
河网提取与阈值标定:对 0.25、0.5、1、2、5 平方公里五个候选阈值分别提取河网,每个候选都算出栅格数、河网长度与密度。
阈值选择:有参考河网时按 F1 得分选最优;否则用你指定的数值;两者都没有,就取候选中位数,并明确写下「该选择不具水文标定意义」。
Strahler 分级与子流域:同时计算坡度、坡向、山体阴影。
出口点与流域划分:自动识别水流离开 DEM 边界的域出口,或使用你提供的出口点,吸附到河网后划分流域。
矢量导出:河网、子流域、流域、出口点统一写入一个 GeoPackage。
出图与报告:生成三张中文专题图与
manifest.json。
三、产物长啥样
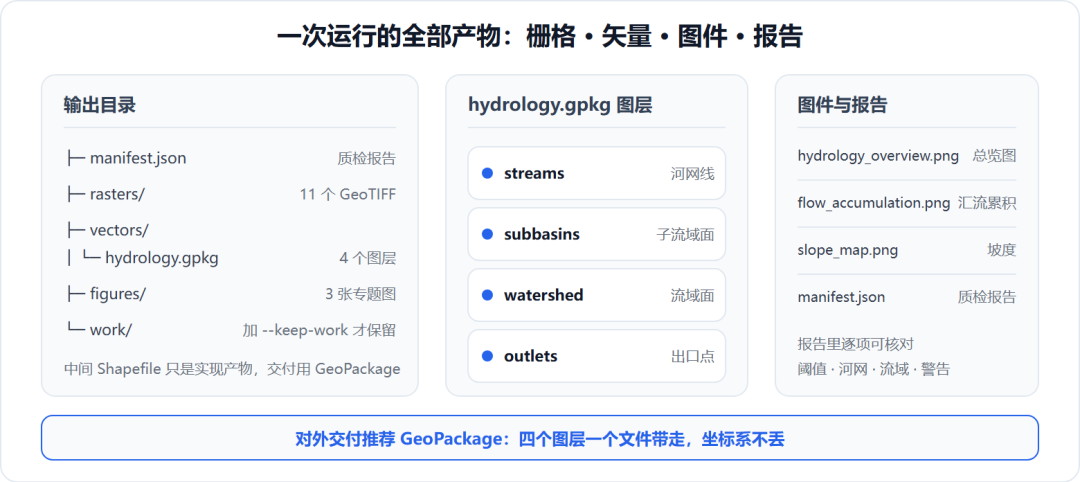
一次成功运行后的输出目录:
output/hydro/ ├── manifest.json 质检报告 ├── rasters/ 11 个 GeoTIFF ├── vectors/hydrology.gpkg ├── figures/ 3 张 PNG 专题图 └── work/ 中间产物,加 --keep-work 才保留
栅格目录里是一整套:填洼前后的 DEM、D8 流向、汇流累积、选定河网、Strahler 分级、子流域、流域,加上坡度、坡向、山体阴影,共 11 个文件。
矢量只有一个 hydrology.gpkg,四个图层:streams(河网线)、subbasins(子流域面)、watershed(流域面)、outlets(吸附后的出口点)。技能文档特别说明,中间的 Shapefile 只算实现产物,对外交付推荐 GeoPackage——一个文件带走全部图层,坐标系不会丢,交付时省心不少。中间转换出来的 Shapefile 有时不带坐标系文件,脚本会按分析 CRS 补上再写入,避免图层在别的软件里变成「未知坐标系」。
专题图三张:水文分析总览(山体阴影叠子流域、河网与出口点)、D8 汇流累积、坡度图。环境里有 CJK 字体时,图内标注是中文。脚本还会顺手检查三张图的文件体积,偏小就写进警告,提示可能渲染异常。
四、质检报告
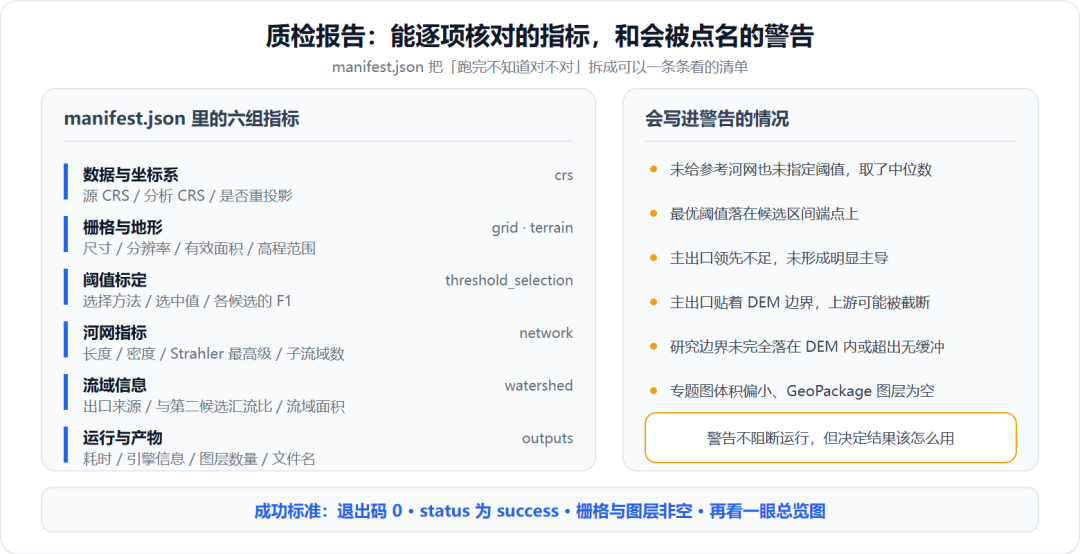
manifest.json 是这个技能我最喜欢的设计,它把「跑完不知道对不对」拆成了逐项核对。
数据与坐标系:源 CRS、是否用了覆盖声明、实际分析 CRS、有没有发生重投影,以及栅格尺寸、分辨率、有效栅格数与有效面积。
地形与汇流:高程范围、最大汇流累积栅格数及其对应的上游面积。
边界覆盖度:研究区边界落在 DEM 有效范围内的比例。
阈值标定:选中的方法(参考河网 F1 最优/用户指定/候选中位数)、选中值,以及每个候选阈值的栅格数、长度、密度与 F1 明细。匹配容差默认 2 个栅格,先把提取结果按容差膨胀,再算 precision、recall 与 F1。
河网指标:河网长度、河网密度、Strahler 最高级、子流域数量。
流域信息:出口点来源、主出口与第二候选的汇流比、划分出的流域面积。
最后是警告清单。从脚本逻辑看,它至少会在这几种情况下出声:没有参考河网也没指定阈值;最优阈值正好落在候选区间端点上;主出口与第二候选差距不够大,没形成明显主导出口;主出口贴着 DEM 边界,上游来水可能被截断;研究边界没完全落在 DEM 里,或者超出 DEM 范围又没有缓冲;再就是 GeoPackage 里哪个图层是空的,警告会直接点名,并提示回头检查阈值与出口点设置。这些警告不是报错,但每一条都在提醒结果该怎么用。
技能文档还写了成功标准,不是「文件存在」就算完:退出码为 0、manifest.json 里 status 为 success、核心栅格齐全、GeoPackage 四个图层非空、三张图非空,最后还要人自己看一眼总览图。
报告开头记着生成时间、耗时、引擎信息(WhiteboxTools 经 pywbt 调用,MIT 许可)和二进制缓存目录;结尾的 outputs 段列出 manifest、栅格目录、GeoPackage 的各图层数量和三张图的文件名。要复现一次结果,看这几段就够了。
五、怎么调用
在 WorkBuddy 技能市场装好之后,直接对话调用就行,比如:
「帮我跑一遍这份 DEM 的河网提取和子流域划分,结果输出到 hydro 目录」
「这是研究区边界和参考河网,帮我标定一下汇水面积阈值」
「先给这份 DEM 做个体检,看看坐标系和 NoData 有没有问题」
命令行用法就两种。先体检:
python scripts/hydrology.py inspect --dem "./data/dem.tif"
再跑完整分析:
python scripts/hydrology.py run \ --dem "./data/dem.tif" \ --boundary "./data/boundary.geojson" \ --reference-streams "./data/streams.geojson" \ --dem-crs-override EPSG:4326 \ --output-dir "./output/hydro"
--boundary、--reference-streams、--pour-points 都是可选的;阈值可以用 --thresholds-km2 改(默认 0.25,0.5,1,2,5),也可以用 --default-threshold-km2 指定一个数或写 auto。--dem-crs-override 只在 DEM 确实没有坐标系、而且有可靠依据时使用,覆盖声明会写进报告。想留着中间文件排查,加 --keep-work。
自动识别出口点时会保留 5 个候选,主出口要领先第二名 1.5 倍才算明显主导,这两个数分别由 --max-outlets 和 --main-outlet-ratio 控制;出口点吸附距离默认取 3 倍分辨率,也可以用 --snap-distance-m 指定。
六、边界与注意
先说依赖。Python 3.9 以上;首次运行脚本会尝试自动安装 numpy、rasterio、pyproj、shapely、geopandas、matplotlib、pywbt,离线环境请提前执行 pip install -r scripts/requirements.txt。WhiteboxTools 二进制约 90 MB,由 pywbt 在首次调用时下载,默认缓存在用户主目录下的 .cache/wbt,可用 --wbt-root 换位置,所以第一次跑必须联网。
遇到问题时也不用靠猜:脚本用退出码区分情况,0 是成功,1 是运行时错误,2 是输入或参数错误,3 是依赖缺失。
再说耗时。下载是一次性开销,真正跑起来的时间随 DEM 尺寸增长;候选阈值每多一个,就多一遍河网提取,大范围数据可以把 --thresholds-km2 收窄到两三个候选。
分辨率这件事必须说清。技能文档里的结论是:30 米量级的分辨率,只适合表达区域尺度的地形控制排水格局;窄城市河道、地下管道、涵洞、路侧排水、堤防、闸门、精细岸线,它解析不了,这类用途需要更高分辨率、做过水文修正的地形数据,外加排水设施数据。
还有几条硬边界:行政区划边界不是天然分水岭;贴着 DEM 边界的流域,在 DEM 外没有地形数据时会被截断,面积只代表 DEM 范围内的汇水范围;参考河网仅用于阈值评分,绝不当结果输出,因为它可能包含人工渠道或概化几何。另外,不要给下游工具传 --esri_pntr,WhiteboxTools 原生的 D8 编码不是 ESRI 约定,脚本内部已经处理好了。
最后是不承诺的部分:这个技能不提供实测流量、洪水水深、淹没范围、法定河流边界、城市暗管,也不承诺被裁剪 DEM 的完整上游面积。这些需要额外的水文观测、水动力模型或权威管线数据,不是一份 DEM 能算出来的。
一句话总结:它负责把可复现的部分做到可复现,把不可靠的部分明确标出来。
我是文茂,热衷于分享 AI 工具与开发者生态观察。觉得有用欢迎点赞、在看、转发三连。